
Last observation: 7 oct. 2026 (N = 7)
First observation: 5 janv. 1983 (N = 2)
Last data update: 07 oct. 2026, 06:32
Last compile: 07 oct. 2026, 06:48
stocks_catalog recense les actions suivies sur investing.com : 39 952 sociétés de 91 pays (nom, ISIN, devise, identifiant). L’historique de cours quotidien (OHLCV) est constitué pour la France (stocks_FRA, 749 valeurs), les États-Unis (stocks_USA, 62 valeurs) et 26 grandes capitalisations mondiales (stocks, ci-dessous) — Europe hors France, Suisse, Japon, Corée, Taïwan, Hong Kong — absentes des deux panels précédents. Voir aussi stocks_FRA et stocks_USA.
cat_df <- stocks_cat |>
  mutate(pays = str_to_title(country)) |>
  count(pays, name = "n") |>
  slice_max(n, n = 26) |>
  add_flag_color("pays") |>
  mutate(slug   = to_slug(pays),
         flag   = ifelse(is.na(slug), NA_character_,
                         file.path("..", "..", "icon", "flag", "round",
                                   paste0(slug, ".png"))),
         color  = ifelse(is.na(color) | toupper(color) %in% c("#FFFFFF", "#FEFEFE"),
                         "grey65", color)) |>
  arrange(n) |> mutate(rk = row_number())

ggplot(cat_df, aes(n, rk)) +
  geom_col(aes(fill = color), width = 0.72, colour = "grey60", linewidth = 0.2,
           orientation = "y") +
  geom_text(aes(label = format(n, big.mark = " ")), hjust = -0.2, size = 2.8,
            colour = "grey30") +
  ggimage::geom_image(aes(x = -max(n) * 0.045, image = flag), size = 0.03,
                      asp = 1.1, na.rm = TRUE) +
  scale_fill_identity() +
  scale_y_continuous(breaks = cat_df$rk, labels = cat_df$pays,
                     expand = expansion(add = 0.8)) +
  scale_x_continuous(expand = expansion(mult = c(0.10, 0.10))) +
  theme_minimal() + xlab("Nombre de sociétés cotées suivies") + ylab("")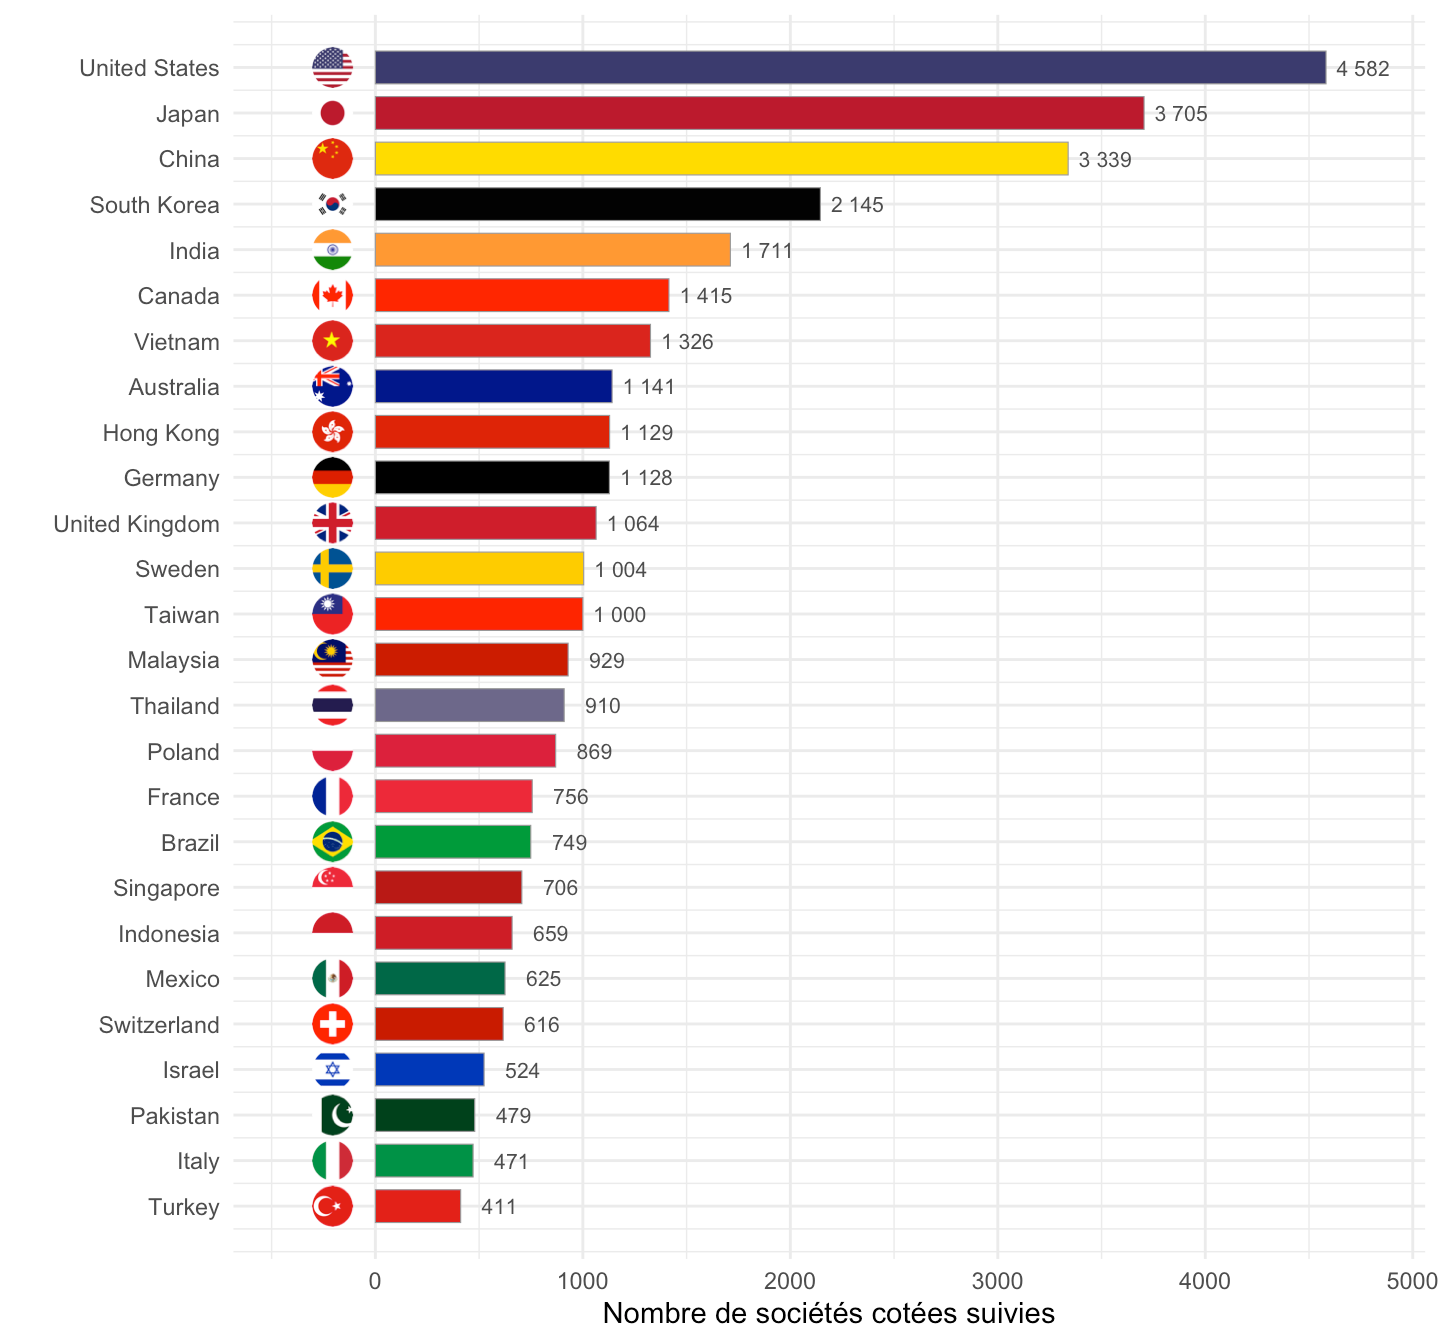
Ailleurs qu’en France et aux États-Unis, seule la fiche signalétique est disponible — pas encore l’historique de cours.
Cours rebasés à 100 début 2005, échelle logarithmique. Couleur = couleur caractéristique du drapeau, icône du pays en fin de série.
sel <- tribble(
  ~symbol, ~lab,         ~src,
  "AAPL",  "Apple",      "USA",  "MSFT", "Microsoft", "USA",
  "JPM",   "JPMorgan",   "USA",  "KO",   "Coca-Cola", "USA",
  "LVMH",  "LVMH",       "FRA",  "OREP", "L'Oréal",   "FRA",
  "SASY",  "Sanofi",     "FRA",  "TOTF", "TotalEnergies", "FRA")

grab <- function(df, src_) df |>
  semi_join(filter(sel, src == src_), "symbol") |> deglitch() |>
  inner_join(filter(sel, src == src_), "symbol") |>
  transmute(lab, src, Date, Close = as.numeric(Close))

px <- bind_rows(grab(stocks_USA, "USA"), grab(stocks_FRA, "FRA")) |>
  filter(Date >= as.Date("2005-01-01"), !is.na(Close), Close > 0) |>
  mutate(pays = ifelse(src == "USA", "United States", "France")) |>
  group_by(lab) |> arrange(Date) |>
  mutate(y = 100 * Close / first(Close)) |> ungroup()

pal  <- qcol(unique(px$lab))
ends <- px |> group_by(lab, pays) |> slice_max(Date, n = 1) |> ungroup() |>
  arrange(y) |> mutate(ly = log10(y))
gap <- 0.055 * diff(range(log10(px$y)))
for (i in seq_len(nrow(ends))[-1])
  if (ends$ly[i] - ends$ly[i - 1] < gap) ends$ly[i] <- ends$ly[i - 1] + gap
ends <- ends |> mutate(ly = 10^(ly - mean(ly - log10(y))),
                       slug = to_slug(pays),
                       flag = file.path("..", "..", "icon", "flag", "round",
                                        paste0(slug, ".png")))

ggplot(px, aes(Date, y, colour = lab, group = lab)) +
  geom_line(linewidth = 0.6) +
  ggimage::geom_image(data = ends, inherit.aes = FALSE,
    aes(x = max(px$Date) + 250, y = ly, image = flag), size = 0.04, asp = 1.5) +
  geom_text(data = ends, aes(x = max(px$Date) + 520, y = ly, label = lab,
                             colour = lab), hjust = 0, size = 3) +
  scale_colour_manual(values = pal, guide = "none") +
  scale_x_date(expand = expansion(mult = c(0.02, 0.24))) +
  scale_y_log10() +
  theme_minimal() + xlab("") + ylab("Cours rebasé (base 100 = janv. 2005)")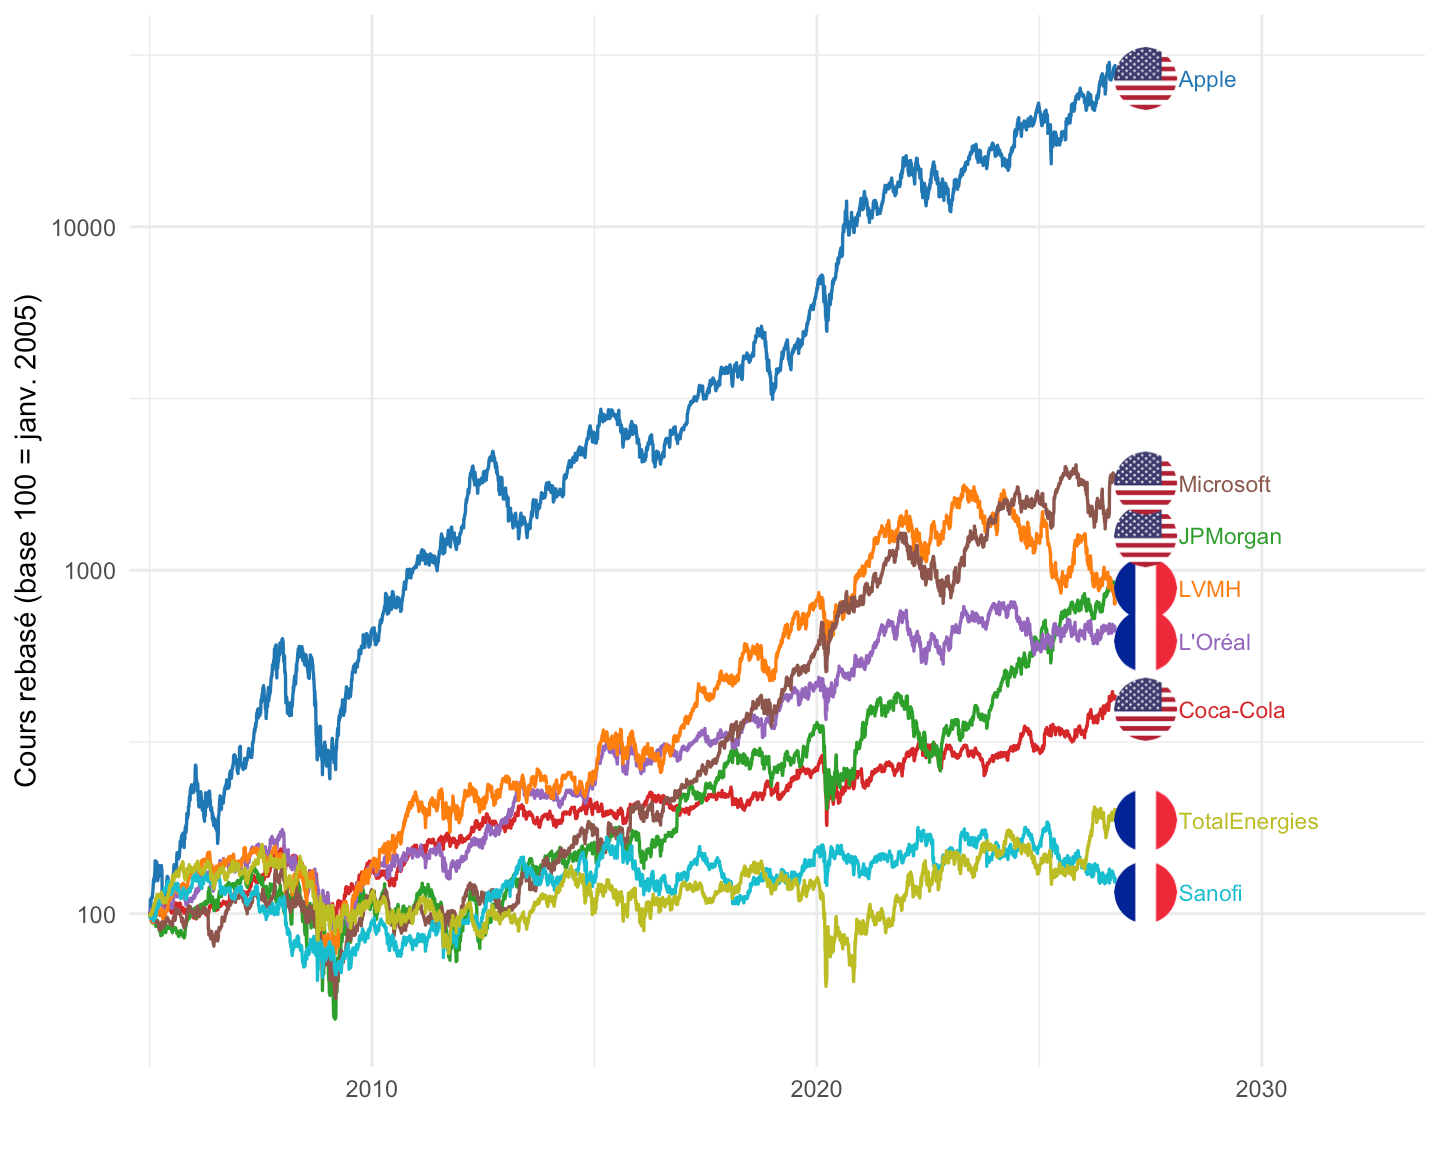
stocks)Quelques poids lourds hors France / États-Unis, cours (devise locale) rebasés à 100 début 2015, échelle logarithmique.
sel <- tribble(
  ~symbol, ~lab,
  "ASML", "ASML",        "NOVOb", "Novo Nordisk",
  "NESN", "Nestlé",      "SAP",   "SAP",
  "7203", "Toyota",      "2330",  "TSMC",
  "0700", "Tencent",     "005930","Samsung Elec.")

px <- stocks |>
  semi_join(sel, "symbol") |> deglitch() |>
  inner_join(sel, "symbol") |>
  filter(Date >= as.Date("2015-01-01"), !is.na(Close), Close > 0) |>
  group_by(lab) |> arrange(Date) |>
  mutate(y = 100 * as.numeric(Close) / first(as.numeric(Close))) |> ungroup()

ends <- px |> group_by(lab) |> slice_max(Date, n = 1) |> ungroup() |>
  arrange(y) |> mutate(ly = log10(y))
gap <- 0.05 * diff(range(log10(px$y)))
for (i in seq_len(nrow(ends))[-1])
  if (ends$ly[i] - ends$ly[i - 1] < gap) ends$ly[i] <- ends$ly[i - 1] + gap
ends$ly <- 10^(ends$ly - mean(ends$ly - log10(ends$y)))

ggplot(px, aes(Date, y, colour = lab, group = lab)) +
  geom_line(linewidth = 0.6) +
  geom_text(data = ends, aes(x = max(px$Date), y = ly, label = lab), hjust = 0,
            size = 3, nudge_x = as.numeric(diff(range(px$Date))) * 0.02) +
  scale_colour_manual(values = qcol(unique(px$lab)), guide = "none") +
  scale_x_date(expand = expansion(mult = c(0.02, 0.22))) +
  scale_y_log10() +
  theme_minimal() + xlab("") + ylab("Cours rebasé (base 100 = janv. 2015)")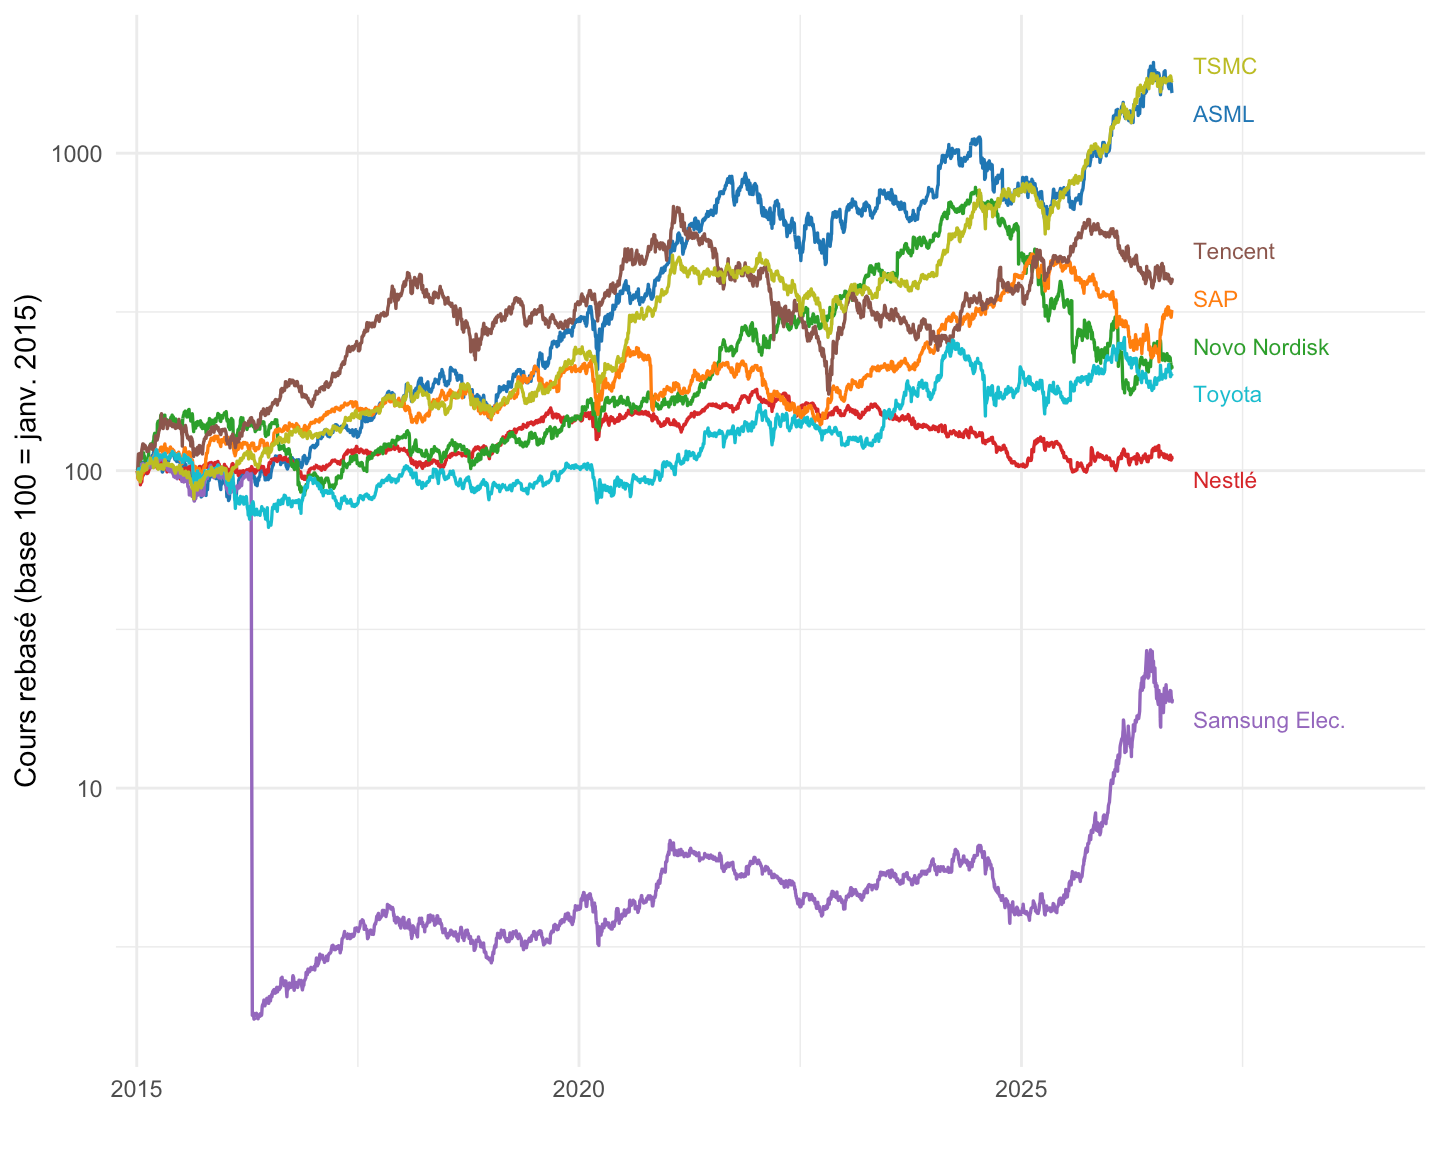
Test du CAPM, \(E[R_i - R_f] = \beta_i \, E[R_m - R_f]\), sur les cours de stocks_USA (62 titres) et stocks_FRA (747 titres), rendements mensuels depuis février 1990. Marché : S&P 500 (États-Unis) et CAC 40 (France), en indices de prix ; taux sans risque : bon du Trésor 3 mois (bonds.parquet), pris en fin de mois précédent.
Trois tests :
Biais connus de ces données, qui ne permettent qu’un test indicatif : (i) les cours (Close) n’incluent pas les dividendes, donc les rendements des titres sont sous-estimés de leur rendement de dividende (marché aussi, indices de prix) ; (ii) biais de survie : ce sont les sociétés encore cotées aujourd’hui (très marqué pour les 62 géants américains) ; (iii) échantillon américain de 62 titres seulement ; (iv) aucun contrôle de la taille, de la valeur, etc.
imap(capm, \(x, nm) tibble(
  Pays = nm, Titres = nrow(x$ts),
  `Mois (période)` = paste(format(min(x$r$month), "%Y-%m"), "à", format(max(x$r$month), "%Y-%m")),
  `Bêta médian` = median(x$ts$beta), `R² médian` = median(x$ts$r2),
  `α moyen (%/mois)` = mean(x$ts$alpha), `α moyen (%/an)` = 12 * mean(x$ts$alpha),
  `Part |t(α)| > 2` = mean(abs(x$ts$t_alpha) > 2),
  `GRS (titres, mois)` = paste0(x$grs$N, ", ", x$grs$T), `GRS F` = x$grs$GRS, `GRS p-value` = x$grs$p_value)) |>
list_rbind() |> mutate(across(where(is.numeric), \(v) round(v, 3))) |> print_table_conditional()| Pays | Titres | Mois (période) | Bêta médian | R² médian | α moyen (%/mois) | α moyen (%/an) | Part |t(α)| > 2 | GRS (titres, mois) | GRS F | GRS p-value |
|---|---|---|---|---|---|---|---|---|---|---|
| États-Unis | 62 | 1990-02 à 2026-09 | 1.255 | 0.229 | 0.348 | 4.179 | 0.129 | 46, 240 | 1.352 | 0.083 |
| France | 587 | 1990-02 à 2026-09 | 0.675 | 0.097 | -0.226 | -2.716 | 0.119 | 208, 240 | 0.797 | 0.821 |
imap(capm, \(x, nm) bind_cols(Pays = nm, x$fm)) |> list_rbind() |>
mutate(across(where(is.numeric), \(v) round(v, 3))) |> print_table_conditional()| Pays | Mois | Titres par mois | γ0 (%/mois) | t(γ0) | γ1 (%/mois) | t(γ1) | Prime de marché (%/mois) |
|---|---|---|---|---|---|---|---|
| États-Unis | 404 | 52 | 0.472 | 1.745 | 0.427 | 1.537 | 0.590 |
| France | 296 | 447 | 0.137 | 0.814 | -0.044 | -0.210 | 0.221 |
Sous le CAPM : \(\gamma_0 = 0\) et \(\gamma_1\) égal à la prime de marché (dernière colonne).
sml <- imap(capm, \(x, nm) x$sml |> mutate(Pays = nm)) |> list_rbind() |>
  rename(ex = `Rendement excédentaire moyen (%/mois)`)
ggplot(sml, aes(x = beta, y = ex)) +
  geom_abline(data = sml |> group_by(Pays) |> summarise(mex = mean(mex)),
              aes(slope = mex, intercept = 0), linetype = "dashed", color = "grey50") +
  geom_smooth(method = "lm", se = FALSE, color = "grey60", linewidth = 0.6) +
  geom_point(color = viridis(3)[1], size = 2) +
  facet_wrap(~Pays, scales = "free") + theme_minimal() +
  labs(x = "Bêta moyen du portefeuille", y = "Rendement excédentaire moyen (%/mois)",
       title = "Portefeuilles triés par bêta (pointillés : SML du CAPM)")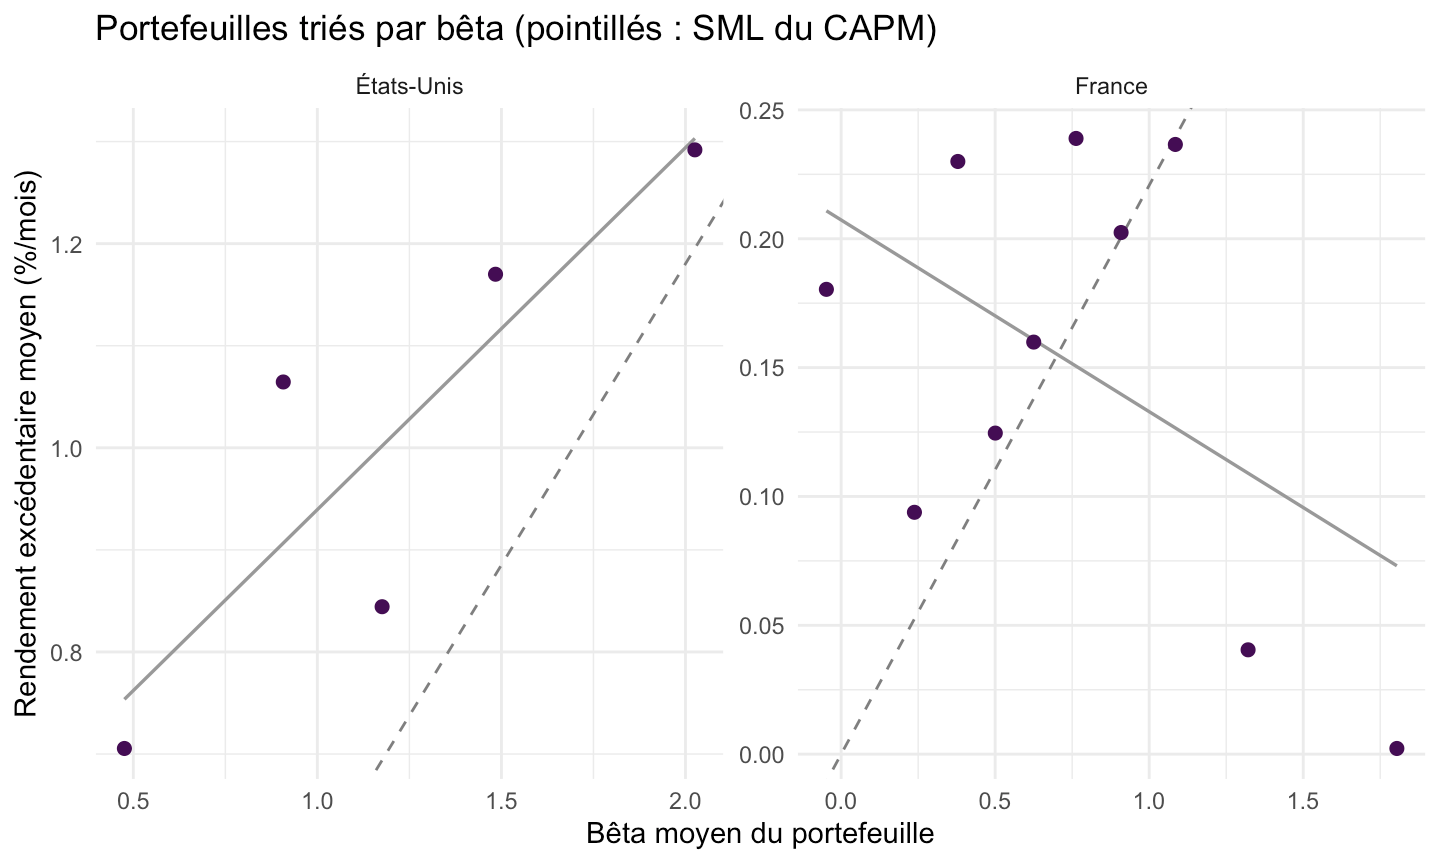
On ajoute au marché local les facteurs de Ken French : taille (SMB), valeur (HML), rentabilité (RMW), investissement (CMA) et momentum (WML) ; facteurs américains pour les titres américains (FF5.parquet, FF_MOMENTUM.parquet) et facteurs européens pour les titres français (FF5_Europe.parquet, FF_MOM_Europe.parquet, disponibles depuis novembre 1990). Les facteurs européens sont exprimés en USD ; comme ce sont des portefeuilles long-short, l’effet de change y est faible, et le marché reste le CAC 40 en euros avec le taux 3 mois français.
On compare les alphas : un bon modèle les rapproche de zéro (GRS plus faible, moins d’alphas significatifs).
ff_dir <- here::here("data", "fama-french")
ff_us <- read_parquet(file.path(ff_dir, "FF5.parquet")) |>
  inner_join(read_parquet(file.path(ff_dir, "FF_MOMENTUM.parquet")), by = "date") |>
  transmute(month = as.Date(date), SMB, HML, RMW, CMA, WML = `Momentum Factor`)
ff_eu <- read_parquet(file.path(ff_dir, "FF5_Europe.parquet")) |>
  inner_join(read_parquet(file.path(ff_dir, "FF_MOM_Europe.parquet")), by = "date") |>
  transmute(month = as.Date(date), SMB, HML, RMW, CMA, WML)

models <- list("CAPM" = "mex", "Fama-French 3" = c("mex", "SMB", "HML"),
               "Fama-French 5" = c("mex", "SMB", "HML", "RMW", "CMA"),
               "FF5 + momentum" = c("mex", "SMB", "HML", "RMW", "CMA", "WML"))

# alphas titre par titre + GRS multifacteur (titres complets sur les 240 derniers mois)
fit_model <- function(r, fac, rhs, min_obs = 120, Tm = 240) {
  d <- r |> inner_join(fac, by = "month") |> filter(month >= as.Date("1990-12-01"))
  ts <- d |> group_by(symbol) |> filter(n() >= min_obs) |>
    group_modify(\(x, k) { f <- lm(reformulate(rhs, "ex"), x); s <- summary(f)$coefficients
      tibble(alpha = s[1, 1], t_alpha = s[1, 3], r2 = summary(f)$r.squared) }) |> ungroup()
  wide <- d |> semi_join(ts, "symbol") |> select(symbol, month, ex) |>
    pivot_wider(names_from = symbol, values_from = ex) |>
    inner_join(d |> distinct(month, across(all_of(rhs))), by = "month") |> arrange(month) |> tail(Tm)
  keep <- setdiff(names(which(colSums(!is.na(wide)) == nrow(wide))), c("month", rhs))
  Kf <- length(rhs); Nn <- length(keep)
  p <- NA_real_; G <- NA_real_
  if (Nn >= 10 && Nn < Tm - Kf - 10) {
    Y <- as.matrix(wide[, keep]); Fm <- as.matrix(wide[, rhs]); X <- cbind(1, Fm)
    B <- solve(crossprod(X), crossprod(X, Y)); E <- Y - X %*% B; S <- crossprod(E) / (Tm - Kf - 1); a <- B[1, ]
    mu <- colMeans(Fm); Om <- cov(Fm)
    G <- (Tm / Nn) * ((Tm - Nn - Kf) / (Tm - Kf - 1)) * as.numeric(t(a) %*% solve(S) %*% a) /
      (1 + as.numeric(t(mu) %*% solve(Om) %*% mu))
    p <- pf(G, Nn, Tm - Nn - Kf, lower.tail = FALSE)
  }
  tibble(Titres = nrow(ts), `|α| moyen (%/an)` = 12 * mean(abs(ts$alpha)),
         `α moyen (%/an)` = 12 * mean(ts$alpha), `Part |t(α)| > 2` = mean(abs(ts$t_alpha) > 2),
         `R² médian` = median(ts$r2), `GRS (titres)` = Nn, `GRS F` = G, `GRS p-value` = p)
}

list("États-Unis" = list(r = capm[["États-Unis"]]$r, fac = ff_us),
     "France"     = list(r = capm[["France"]]$r,     fac = ff_eu)) |>
  imap(\(x, nm) imap(models, \(rhs, mn) bind_cols(Pays = nm, Modèle = mn, fit_model(x$r, x$fac, rhs))) |> list_rbind()) |>
list_rbind() |> mutate(across(where(is.numeric), \(v) round(v, 3))) |> print_table_conditional()| Pays | Modèle | Titres | |α| moyen (%/an) | α moyen (%/an) | Part |t(α)| > 2 | R² médian | GRS (titres) | GRS F | GRS p-value |
|---|---|---|---|---|---|---|---|---|---|
| États-Unis | CAPM | 61 | 8.016 | 4.186 | 0.131 | 0.230 | 46 | 1.356 | 0.081 |
| États-Unis | Fama-French 3 | 61 | 8.477 | 4.031 | 0.180 | 0.276 | 46 | 1.340 | 0.090 |
| États-Unis | Fama-French 5 | 61 | 9.285 | 4.771 | 0.180 | 0.305 | 46 | 1.313 | 0.106 |
| États-Unis | FF5 + momentum | 61 | 8.965 | 5.455 | 0.213 | 0.312 | 46 | 1.299 | 0.115 |
| France | CAPM | 586 | 11.839 | -2.423 | 0.125 | 0.095 | 208 | 0.675 | 0.942 |
| France | Fama-French 3 | 586 | 11.593 | -4.103 | 0.123 | 0.151 | 208 | 0.641 | 0.959 |
| France | Fama-French 5 | 586 | 11.740 | -3.238 | 0.126 | 0.164 | 208 | 0.830 | 0.768 |
| France | FF5 + momentum | 586 | 12.074 | -3.111 | 0.123 | 0.172 | 208 | 0.747 | 0.865 |