Last data update: 26 oct. 2026, 20:05
Last compile: 26 oct. 2026, 20:06
Pondérations élémentaires 2026 de l’IPC : 20 414 lignes, pour 3298 variétés et 98 agglomérations, tranches d’agglomérations ou territoires. Le niveau élémentaire d’agrégation est soit la variété seule, soit la variété par agglomération ou par tranche d’agglomérations. Les pondérations sont exprimées dans une unité propre à l’Insee (non normalisée à 100).
Il n’existe pas de base de sondage retraçant l’ensemble de la consommation des ménages par articles et points de vente. La consommation est donc d’abord décomposée par types de produit, appelés « variétés », choisis pour refléter l’hétérogénéité des postes de la nomenclature COICOP ; l’échantillon est mis à jour chaque année. Pour les relevés en points de vente physiques, un sondage à deux degrés tire des agglomérations (en plus de chaque territoire d’outre-mer) puis des produits et des points de vente par quotas ; les relevés Internet et les données de caisse suivent des règles spécifiques. La liste des variétés n’est pas diffusée au niveau fin dans l’IPC.
pond |>
  count(niveau) |>
  ggplot(aes(x = n, y = fct_reorder(niveau, n))) +
  geom_col(fill = bleu) +
  geom_text(aes(label = format(n, big.mark = " ")), hjust = -0.1) +
  scale_x_continuous(labels = ~ format(.x, big.mark = " "), expand = expansion(mult = c(0, 0.15))) +
  theme_ref() +
  labs(x = "Nombre de pondérations", y = NULL, title = "Niveaux élémentaires d'agrégation")
pond |>
  ggplot(aes(x = ponderation)) +
  geom_histogram(bins = 60, fill = rose) +
  scale_x_log10(labels = ~ format(.x, big.mark = " ")) +
  theme_ref() +
  labs(x = "Pondération (échelle log)", y = "Nombre de lignes",
       title = "Distribution des pondérations élémentaires",
       subtitle = sprintf("médiane : %.1f ; maximum : %s", median(pond$ponderation), format(round(max(pond$ponderation)), big.mark = " ")))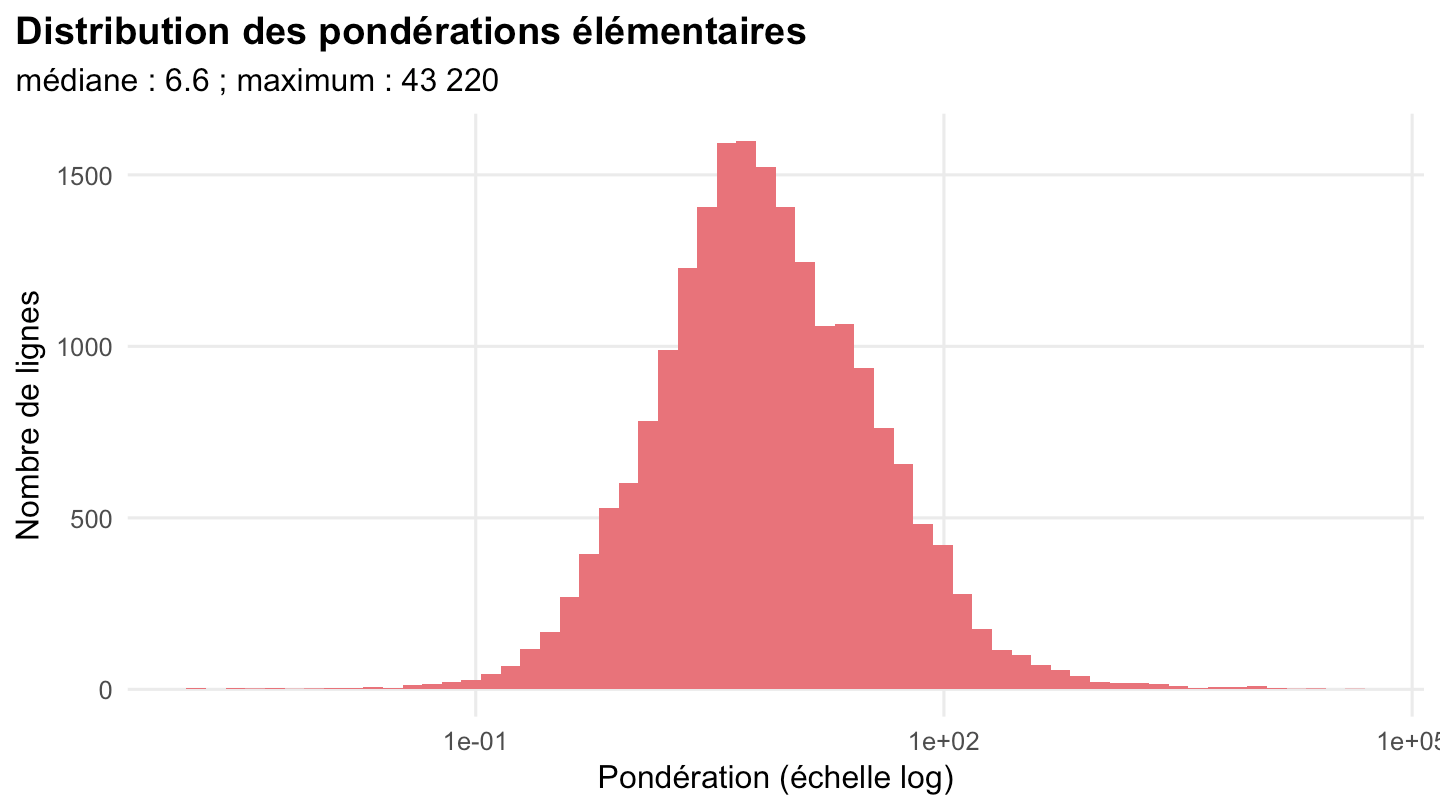
pond |>
  filter(niveau == "variété") |>
  slice_max(ponderation, n = 25, with_ties = FALSE) |>
  mutate(lab = str_trunc(str_to_sentence(variete), 50), terr = agglomeration) |>
  ggplot(aes(x = ponderation, y = fct_reorder(paste0(lab, " - ", terr), ponderation))) +
  geom_col(fill = bleu) +
  geom_text(aes(label = format(round(ponderation), big.mark = " ")), hjust = -0.1, size = 3) +
  scale_x_continuous(labels = ~ format(.x, big.mark = " "), expand = expansion(mult = c(0, 0.15))) +
  theme_ref() +
  labs(x = "Pondération", y = NULL, title = "Les 25 pondérations les plus élevées au niveau « variété »")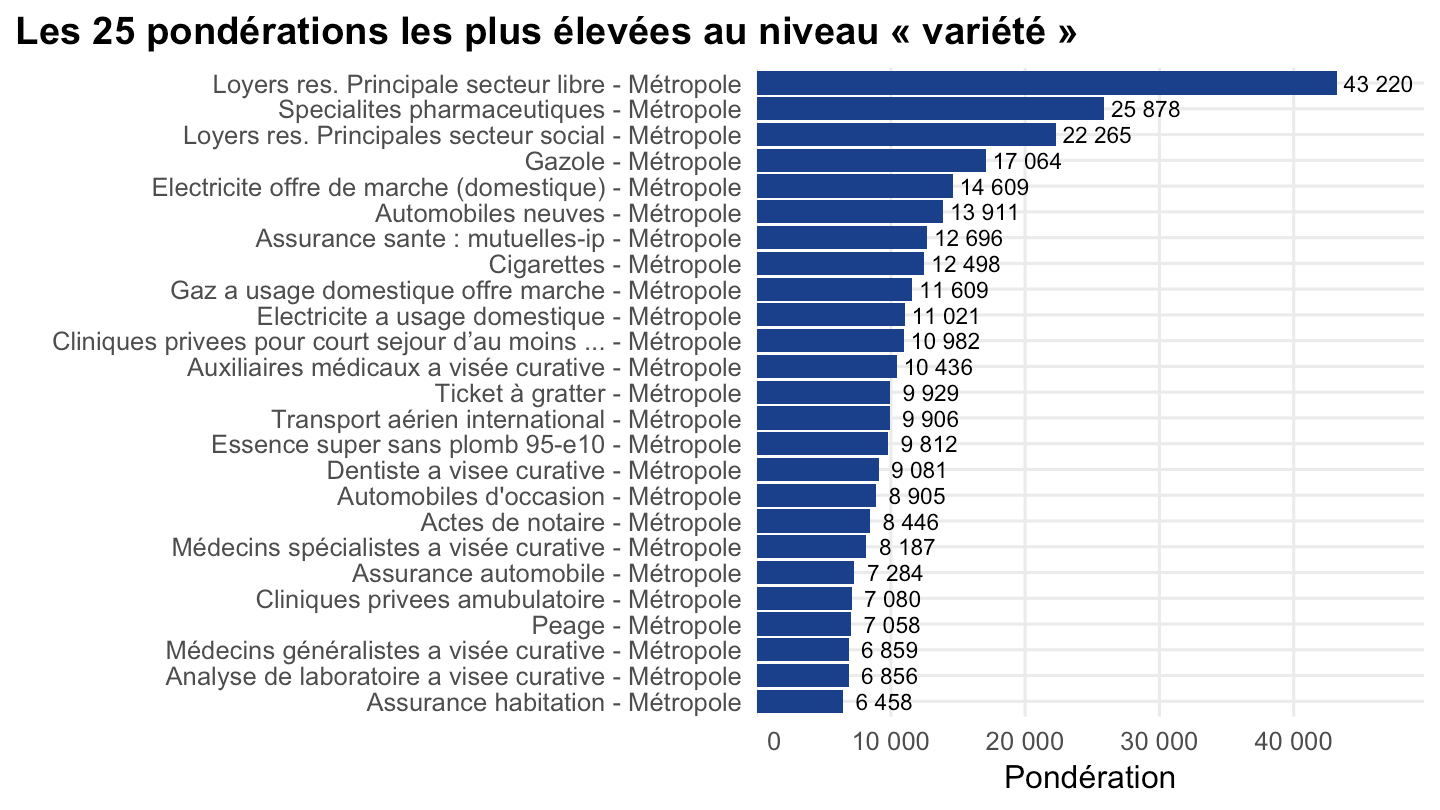
pond |>
  count(agglomeration) |>
  slice_max(n, n = 25, with_ties = FALSE) |>
  ggplot(aes(x = n, y = fct_reorder(agglomeration, n))) +
  geom_col(fill = vert) +
  geom_text(aes(label = n), hjust = -0.2, size = 3.2) +
  scale_x_continuous(expand = expansion(mult = c(0, 0.1))) +
  theme_ref() +
  labs(x = "Nombre de pondérations", y = NULL, title = "Territoires comptant le plus de pondérations élémentaires")
pond |> arrange(desc(ponderation)) |> head(100) |>
print_table_conditional()pond |> arrange(desc(ponderation)) |>
print_table_conditional()